번역본. 원문:
The AI Engineering Skills Map Part 2 — AI Applications.md(Andrew Ng, The Batch / DeepLearning.AI)
실제 현장에서 AI 애플리케이션을 만들고 배포하려면 무엇을 알아야 하는가
친애하는 여러분,
앞서 저는 AI 엔지니어링 스킬 맵에 대해 썼습니다. 최상위 역량은 (i) AI 애플리케이션 구축 및 배포, (ii) 소프트웨어 엔지니어링 기초, (iii) 코딩 에이전트 활용, (iv) 빌드의 방향 설계였습니다. 이번 레터에서는 그중 첫 번째를 구체화하겠습니다.
AI 애플리케이션 구축과 배포에 능하다는 것은 다음을 안다는 뜻입니다.
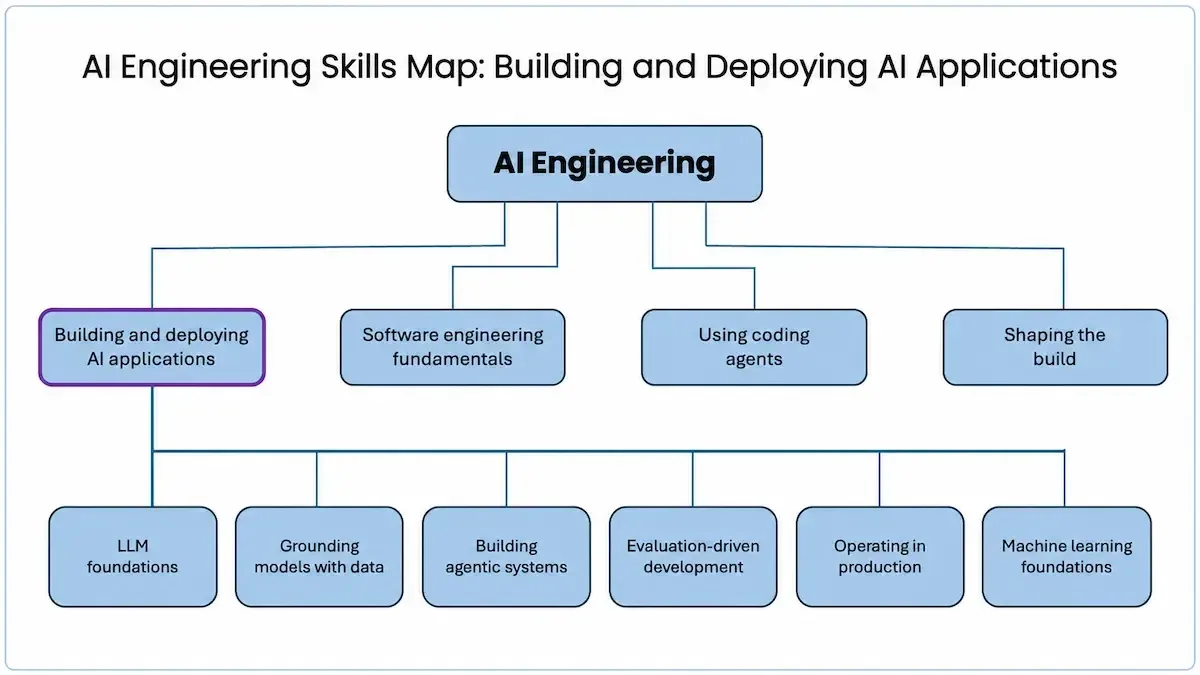
- LLM 기초
- 데이터로 모델 그라운딩하기
- 에이전틱 시스템 구축
- 평가 주도 개발(evaluation-driven development)
- 프로덕션 운영
- 머신러닝 기초
이 역량 지도는 다수의 채용 공고 분석, 구조화된 전문가 인터뷰, 설문 응답을 토대로 만들어졌습니다.
AI 애플리케이션과 비AI 소프트웨어의 핵심 차이는 전자의 출력이 덜 예측 가능하다는 점입니다. LLM이 무엇을 출력할지, 지도학습 알고리즘이 어떤 예측을 내놓을지 사전에 알 수 없습니다. 이 불확실성 때문에 AI 시스템 구축은 전통적인 소프트웨어 구축보다 훨씬 반복적인 과정이 되며, 과정을 미리 계획하기가 더 어렵습니다. 숙련된 AI 엔지니어는 소프트웨어를 만들고, 살펴보고, 다음에 무엇을 시도할지 정하는 일을 반복하며, 중간 결과에 크게 영향을 받는 일련의 단계를 밟아 나갑니다. 다음에 무엇을 할지 능숙하게 결정할 수 있어야 신뢰할 수 없는 AI 구성 요소 위에 신뢰할 수 있는 소프트웨어 시스템을 만들 수 있습니다. 이를 위해 필요한 것들은 다음과 같습니다.
LLM 기초. 대규모 언어 모델이 입력을 어떻게 토큰화하고 출력을 어떻게 생성하는지 이해하면, 언제 모델을 믿을 수 있고 언제 실패할 수 있는지 알게 됩니다. 또한 언제 멀티모달 모델을 써야 하는지, 컨텍스트 윈도에 무엇을 넣을지에 대한 트레이드오프를 어떻게 잡을지 이해하게 되고, 캐시 적중, 지식 컷오프, 추론 강도(reasoning effort) 수준, 샘플링 파라미터, 그리고 툴 호출 같은 특수 기능을 언제 쓸지 추론할 수 있게 됩니다. 이런 기초를 이해하면 적합한 모델 또는 모델 조합을 고르고, 필요할 때 파인튜닝이나 셀프 호스팅 같은 전문적 기법을 적용할 수 있습니다.
데이터로 모델 그라운딩하기. LLM이 쓸모 있는 출력을 내려면 좋은 입력 컨텍스트가 필요합니다. 벡터 검색을 이용한 RAG는 LLM에 관련 컨텍스트를 주기 위한 초기 시도였지만, 데이터로 모델을 그라운딩하는 기법의 폭은 그 사이 크게 넓어졌습니다. 예를 들어 무엇을 프롬프트에 직접 넣고 무엇을 LLM이 툴을 써서 필요할 때 검색하게 할지 정해야 하고, 데이터와 검색 질의에 어떤 표현이 맞는지도 정해야 합니다. 벡터 인덱스일 수도, 지식 그래프일 수도, 고객 레코드 같은 정형 데이터 위의 시맨틱 레이어일 수도 있습니다. 또한 텍스트, PDF, HTML, 이미지 등의 문서를 LLM이 바로 쓸 수 있는 입력으로 변환하고, 데이터를 깨끗하고 최신으로 유지하는 파이프라인을 설계해야 합니다. 데이터를 확보하는 기법의 선택지를 알고 있을수록 LLM에 관련성 높은 컨텍스트를 더 잘 줄 수 있습니다.
에이전틱 시스템 구축. 에이전틱 시스템의 범위는 미리 정해진 순서대로 LLM 호출을 실행하는 워크플로부터, LLM이 다음 단계를 스스로 반복 결정하게 하는 에이전트 하네스 기반 시스템까지 걸쳐 있습니다. 어떤 단계를 체인으로 잇고, 무엇을 병렬화하고, 언제 코드를 쓰고 언제 LLM을 쓸지 등 아키텍처를 선택한 뒤, 폴백까지 포함해 워크플로나 하네스를 설계해야 합니다. 에이전트 루프를 설계할 때는 모델이 호출할 수 있는 툴(MCP, CLI, 샌드박스 실행 환경 포함), 사용할 메모리 아키텍처, 긴 세션에서 컨텍스트를 관리하는 방법, 그리고 언제 단일 에이전트 아키텍처 대신 멀티 에이전트 오케스트레이션이 필요한지도 결정합니다. 또한 가능성 있는 프로토타입을 프로덕션용의 신뢰할 수 있고 안전한 에이전트로 전환해야 하는데, 여기에는 가드레일, 적대적 입력, 데이터 유출 같은 핵심 리스크의 식별과 회피, 그리고 거버넌스에 대한 이해가 필요합니다.
에이전틱 워크플로는 빠르게 진화하고 있으므로, 음성 에이전트, 컴퓨터 사용 에이전트, 생성형 UI 등 자신의 응용 분야와 관련된 최신 기법을 이해해 두면 도움이 됩니다.
평가 주도 개발. 제 경험상 AI 시스템 구축을 잘하는 사람을 가르는 가장 중요한 특성은, 규율 있는 평가/오류 분석 루프로 개발을 이끌 수 있는가입니다. 그래야 성과가 날 가능성이 높은 방향에 반복적으로 힘을 집중할 수 있습니다. 저는 이것이 숙달하기 까다로운 역량이라고 느껴 왔습니다. 올바른 접근법이 프로젝트마다, 심지어 프로젝트의 단계마다 크게 달라지기 때문입니다.
좋은 평가를 만드는 일은 깊은 기술적 역량입니다. 시스템의 트레이스와 출력을 들여다보고, 탐색적 데이터 분석을 수행하고, 거기에 제품·비즈니스 통찰을 결합해 무엇을 측정할지 정하게 됩니다. 또한 평가의 선택지를 이해해야 합니다. 언제 결정론적(코드 기반) 평가를 쓸지, 언제 LLM-as-a-judge를 쓸지, 언제 사람을 루프에 넣을지, 그리고 평가 자체를 어떻게 평가해 계속 진화시킬지 말입니다. 이런 평가는 이후의 개발을 이끄는 반복 과정에 투입되어, 진전을 무작위가 아닌 체계적인 것으로 만듭니다.
프로덕션 운영. AI 소프트웨어의 운영은 예측 불가능성, 비용, 지연 시간 때문에 전통적인 소프트웨어와 다릅니다. 먼저 실제 사용에서의 시스템 성능을 파악할 관측 가능성(observability) 장치를 만들 줄 알아야 합니다. 성능을 추적하고, 드리프트를 감지하고, 모델 실패와 적대적 프롬프트 인젝션 같은 보안 사고에 빠르게 대응해야 합니다. 회귀 테스트와 CI/CD를 갖추는 일은 전통적 소프트웨어보다 더 많은 통계적 평가를 요구하며, 테스트에 들이는 노력은 실수가 초래할 위험의 크기에 맞춰 조정해야 합니다. 여기에 더해, 특히 애플리케이션이 많은 사용자에게 도달할 경우 비용과 지연 시간을 최적화하기 위해 모델 선택 최적화, 증류(distillation)와 파인튜닝, 에이전틱 워크플로 단순화 같은 기법을 적절히 조합할 줄 아는 것이 중요합니다.
머신러닝 기초. 현대 LLM은 지도학습과 강화학습을 포함한 머신러닝 기법으로 만들어집니다. 제가 아는, LLM으로 잘 만드는 엔지니어는 모두 머신러닝과 딥러닝을 어느 정도 깊이로 이해하고 있습니다. 또한 많은 응용에서는 여전히 머신러닝을 쓸 줄 알아야 합니다. 남이 학습시킨 모델이든 직접 학습시킨 모델이든 마찬가지입니다. 이를 위해서는 널리 쓰이는 머신러닝·딥러닝 모델과 정확도, 학습 속도, 추론 속도 등의 트레이드오프를 알아야 하고, 이 모델들을 학습·평가하는 데 필요한 데이터를 설계하는 법을 이해해야 합니다. 편향/분산, 오류 분석, 데이터 엔지니어링이라는 머신러닝 개념은 모두 출력이 불확실한 시스템을 다루는 핵심 사고 틀이며, AI 시스템 개발에서 폭넓은 의사결정을 내리는 데 여전히 결정적입니다.
AI 시스템을 잘 만들고 배포하려면 배울 것이 많습니다. 기술적 깊이가 상당한 분야입니다. 그러나 조금씩 배우는 것 하나하나가 AI 엔지니어링을 더 잘하게 하고 더 흥미로운 애플리케이션을 만들게 해 줍니다. 이 역량을 강하게 보완해 주는 것이 소프트웨어 엔지니어링입니다. 다음 레터에서 이에 대해 더 쓰겠습니다.
계속 만들어 나가세요!
Andrew